1. 结论
一句话结论:另一个智能体值不值得调用,取决于它能否把当前这个候选答案从错改对。按这个边际价值来度量和学习委派,一次选对的调用就能拿到大部分可测得的增益,学到的策略每题只用约半次调用。
最好的一次委派占「直接提交 → 测得 oracle(事后最优)」全部增益的比例。采集集。
四个与采集集不相交的评测,宏平均 50.6% → 67.7%。其中 MedQA、MMLU-Pro、AQuA-RAT 为锁定评测;GPQA-Diamond 100 同时是它的开发池。
同样四个评测上的平均子智能体调用次数(宏平均 0.526)。
一次选择性调用与强制三次调用准确率相同。开发集诊断。
1.03 次调用高于 3 次强制调用 5.9 pp。开发集诊断。
对照诊断,不是 MARGENT 的方法。从 MARGENT 的 SFT checkpoint 出发,只用结果奖励、无调用惩罚继续训练,策略退化为几乎每题三次调用。两次运行没有准确率记录。附录 D。
五条关键发现
- 可回收的价值集中在第一次选对的委派:Gain@1 宏平均 91.7%,第二次调用只多 0.5–4.5 分。采集集
- 一次调用的价值取决于调用谁:同一个 Reasoner 在 MedQA 净值 +6.8 pp,在 AQuA-RAT 是 −4.3 pp,Extractor 在四个任务上都接近零或为负。采集集
- 学到的策略在四个不相交评测上都高于自己的候选答案:宏平均 +17.1 pp,0.526 次调用 / 题;这是同一 scaffold 内的端到端差异,不是相对独立单模型基线的增益。不相交评测
- 约一次选择性调用 ≈ 三次强制调用:宏平均 73.2%@1.03 次 vs 73.6%@3.0 次,MMLU-Pro 持平,AQuA-RAT 反超 5.9 pp,GPQA 落后 6.0 pp。开发集诊断
- 候选答案本身对委派有用,只看结果的 RL 会学成「全都调用」:AQuA-RAT 上置空传给 Verifier 的候选答案,准确率 81.1% → 74.0%;只用结果奖励的 GRPO 继续训练走到 2.98–3.00 次调用 / 题,但没有准确率记录。开发集诊断
2. 方法
2.1 决策接口
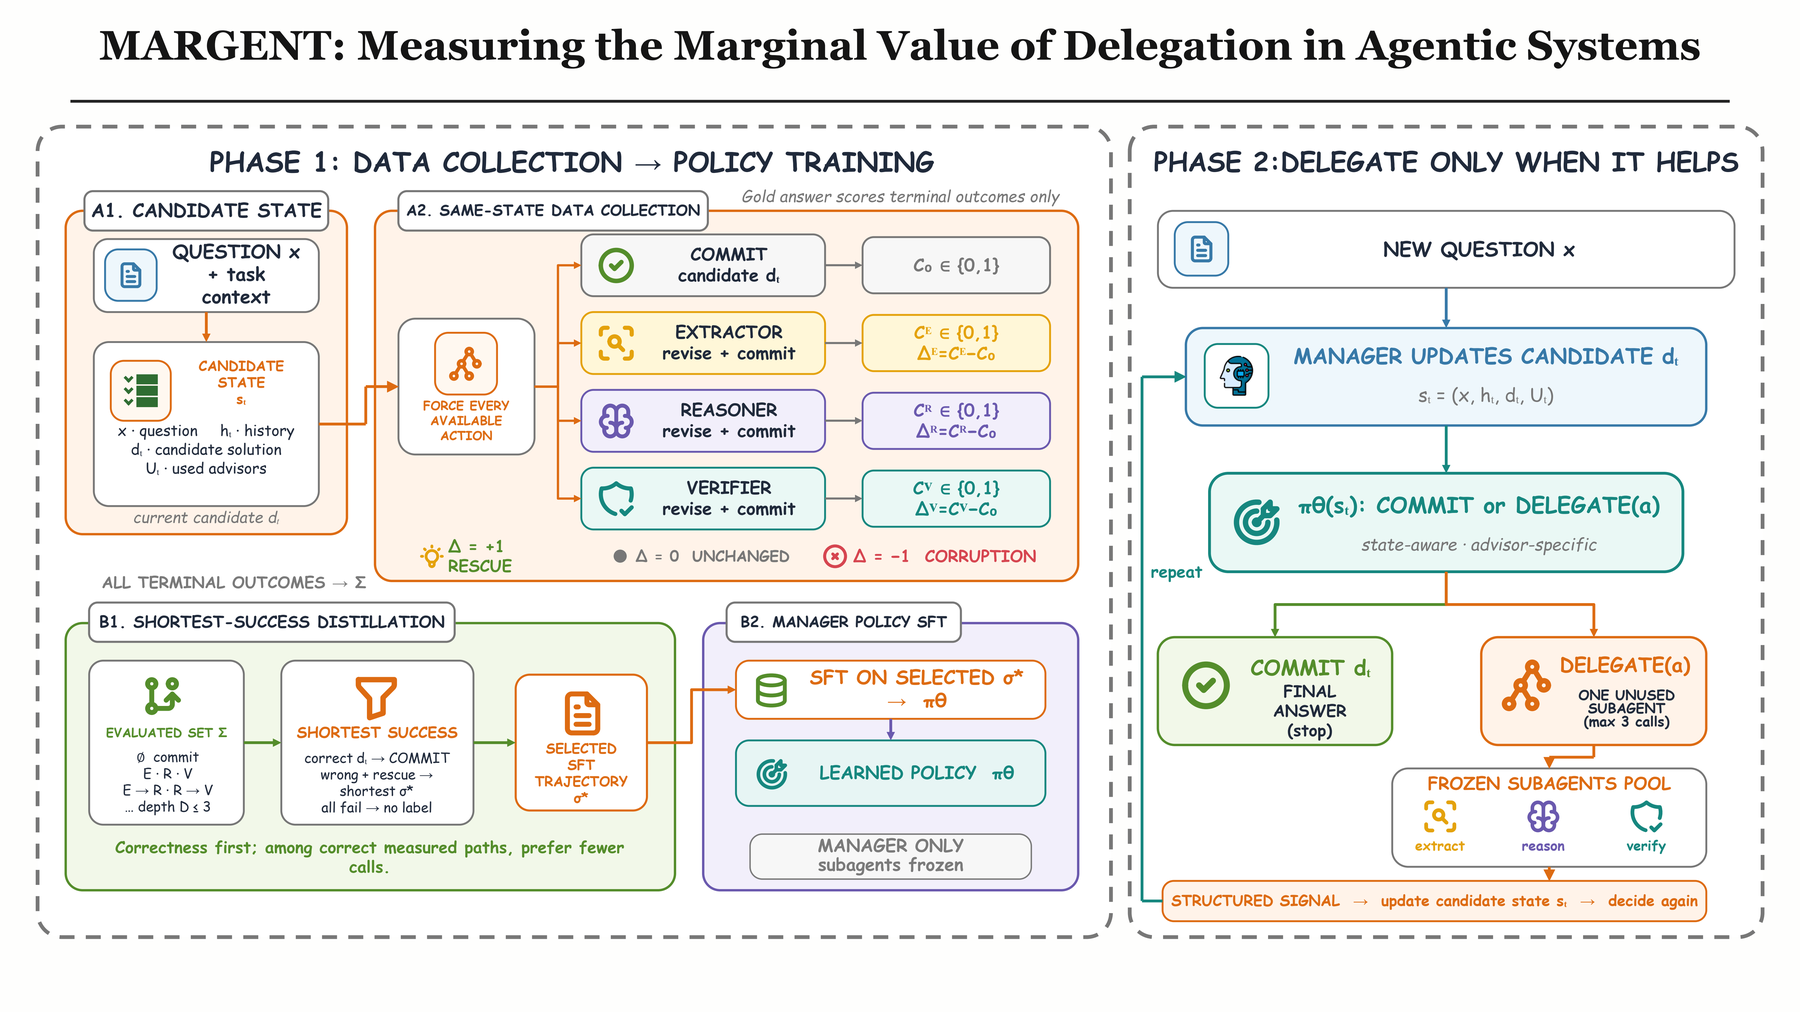
系统里有一个可训练的 manager(Qwen3.5-9B)和三个冻结的子智能体;每一轮 manager 先写下候选答案,再二选一:提交,或委派给一个还没用过的子智能体。第 t 轮的状态是 s_t = (x, h_t, ŷ_t, U_t)(问题、交互历史、当前候选答案、已用过的子智能体集合),每个子智能体最多调用一次,所以一条轨迹最多 3 次委派。
u_t ∈ {commit} ∪ {delegate(a) : a ∈ A \ U_t}。(论文式 1)
| 子智能体 | 返回什么 | 接收什么 |
|---|---|---|
| Extractor | 与决策相关的事实及其极性 | 问题与上下文 |
| Reasoner | 问题分解、缺失的推理步骤 | 问题与上下文 |
| Verifier | 对当前候选答案的审计 | 问题与上下文,加上 manager 当前的候选答案 |
2.2 边际价值的定义
Δ(s_t, a) = C(s_t, delegate(a)) − C(s_t, commit) ∈ {−1, 0, +1}。(论文式 2)
C(s_t, commit) 是直接提交当前候选答案是否正确;C(s_t, delegate(a)) 是强制委派给 a、让 manager 修订后立即提交这条分支是否正确。+1 是救回,0 是没变,−1 是损坏;它度量的是「调用、修订、提交」整个操作在固定修订协议下的效果,不是子智能体能力的内在度量。
2.3 同状态干预采集
- 每道训练题先由温度 0 的 manager 不委派地生成根候选答案;从这个共同的根状态,强制「直接提交」和「委派给每个子智能体」。
- 按广度优先枚举不重复子智能体的有序序列,最大深度 D ≤ 3;根错误时逐层评估,在首个出现成功的深度停止,并保留该层所有等长的成功序列。
- 根正确时只评估一步委派,留作损坏分析;标准答案只用来给终端分支打分,从不展示给 manager 或子智能体。
2.4 边际价值蒸馏
| 根候选答案 | 采集到的分支 | 蒸馏目标 |
|---|---|---|
| 正确 | 只展开一步,用于损坏分析 | 直接提交(Σ* = {ε}) |
| 错误,在深度 d 首次出现成功 | 停在深度 d,保留该层所有成功序列 | 从最短成功序列中按该题固定的种子均匀抽一条:d 次调用后提交 |
| 错误,到深度 D 都没有成功 | 所有层都评估完 | 无标签(Σ* = ∅):既不教提交,也不教委派 |
提交轨迹的数量被限制在救回轨迹数量的 ρ 倍以内(ρ 即提交/救回比,是数据构造超参数);SFT 更新完整的 manager,所以候选答案到最终答案的增益是端到端的,不只是路由效应。
终端正确性奖励分不清「直接提交」和「多余的委派」,每次调用惩罚则引入一个随任务变化的准确率与资源之间的汇率。MARGENT 改用字典序偏好:先看正确,正确的里面再看调用少。
3. 实验设置
| 项目 | 设置 |
|---|---|
| Benchmark | MedQA(医学)、MMLU-Pro(广泛知识)、GPQA(科学)、AQuA-RAT(数学),都是多选题 |
| 采集集规模 | 每个任务 400 个根状态,GPQA 200 个 |
| 开发池 / 锁定评测 | 开发池 MedQA 200、MMLU-Pro 200、AQuA-RAT 254、GPQA 100。锁定评测(固定 checkpoint 后只跑一次)MedQA 500、MMLU-Pro 500、AQuA-RAT 254;GPQA-Diamond 100 与采集集不相交,但就是它的开发池 |
| Manager 与子智能体 | Manager 为 Qwen3.5-9B,只有它被微调;子智能体是同一模型系列上的三个冻结的角色 LoRA |
| 解码 | 干预探针和子智能体调用都用贪心解码 |
| 搜索深度 | MedQA、AQuA-RAT 深度 3;MMLU-Pro、GPQA 深度 2 |
| 提交/救回比 ρ | 扫描 {0, 0.5, 1, 2, 3}。ρ = 0 只保留救回状态,策略几乎每题都委派;ρ 越大,保留的「直接提交已正确」的状态越多 |
| 比较对象 | (i) 同一个 manager 委派前的候选答案;(ii) 强制调用一次 Verifier;(iii) 强制调用全部三个子智能体;(iv) 测得的 oracle:每题选已评估序列中最好的一条 |
| 指标 | exact-match 多选准确率;平均子智能体调用次数;救回 / 纠正概率和损坏概率 |
4. 主要结果
4.1 一次委派之后还有多少价值可拿?采集集
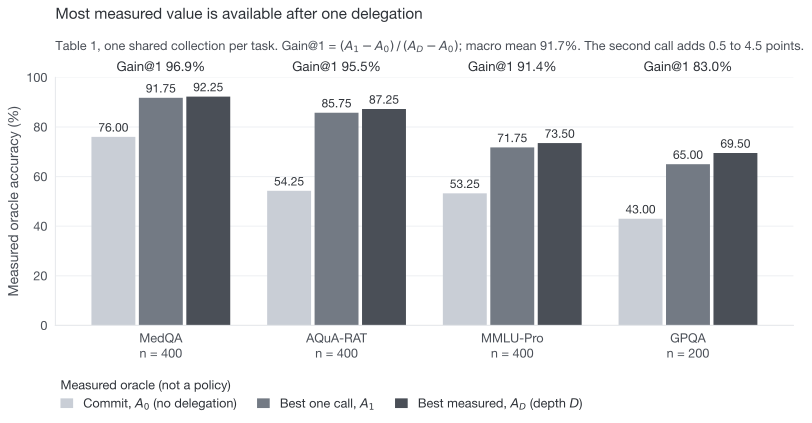
| 任务 | n | 直接提交 A0 | 最好一次调用 A1 | 测得最好 AD | Gain@1 |
|---|---|---|---|---|---|
| MedQA | 400 | 76.00 | 91.75 | 92.25 | 96.9% |
| AQuA-RAT | 400 | 54.25 | 85.75 | 87.25 | 95.5% |
| MMLU-Pro | 400 | 53.25 | 71.75 | 73.50 | 91.4% |
| GPQA | 200 | 43.00 | 65.00 | 69.50 | 83.0% |
| 宏平均 | – | 56.63 | 78.56 | 80.63 | 91.7% |
可回收的价值集中在第一次选对的委派:一次调用在三个任务上拿回测得增益的 90% 以上,宏平均 91.7%。第二次调用只多 0.5–4.5 分,两个深度 3 的采集集上第三次调用多 0 分;GPQA 的直接提交准确率最接近随机,第二次调用多 4.5 分。
4.2 一次调用的价值取决于调用谁采集集
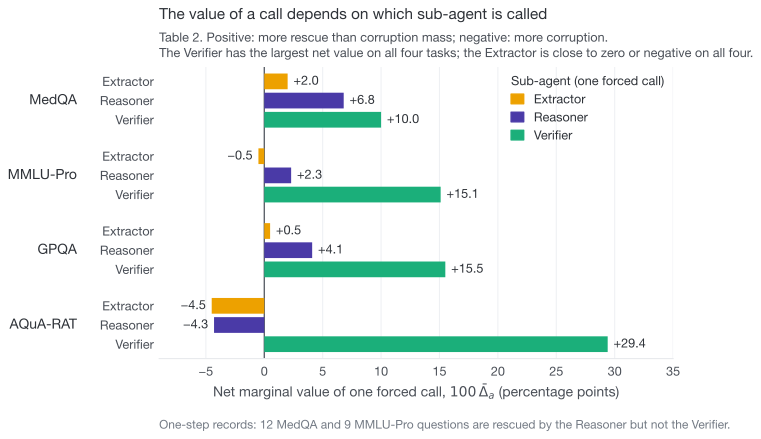
| 任务 | Extractor | Reasoner | Verifier |
|---|---|---|---|
| MedQA | +2.0 | +6.8 | +10.0 |
| MMLU-Pro | −0.5 | +2.3 | +15.1 |
| GPQA | +0.5 | +4.1 | +15.5 |
| AQuA-RAT | −4.5 | −4.3 | +29.4 |
同一个 Reasoner 在 MedQA 净值 +6.8,在 AQuA-RAT 是 −4.3;Extractor 在四个任务上都接近零或为负。Verifier 均值最大但不可替代:12 道 MedQA 和 9 道 MMLU-Pro 题被 Reasoner 救回而 Verifier 救不回。
4.3 与采集集不相交的评测不相交评测
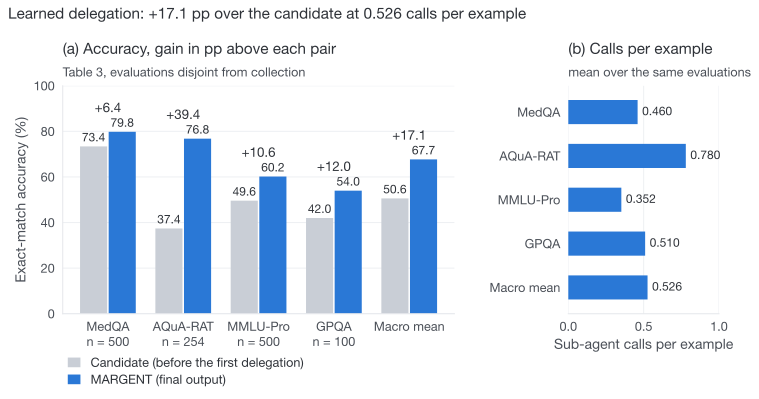
| 任务 | n | 候选答案 | MARGENT | 增益 (pp) | 调用 / 题 |
|---|---|---|---|---|---|
| MedQA | 500 | 73.4 | 79.8 | +6.4 | 0.460 |
| AQuA-RAT | 254 | 37.4 | 76.8 | +39.4 | 0.780 |
| MMLU-Pro | 500 | 49.6 | 60.2 | +10.6 | 0.352 |
| GPQA | 100 | 42.0 | 54.0 | +12.0 | 0.510 |
| 宏平均 | – | 50.6 | 67.7 | +17.1 | 0.526 |
四个评测上 MARGENT 的最终输出都比同一个训练后 manager 委派前的候选答案准确,宏平均高 17.1 pp,每题 0.53 次调用。
SFT 更新的是完整的 manager,所以这是同一 scaffold 内的端到端差异,不只是路由效应,不应读成相对独立单模型基线的增益;AQuA-RAT 上带工具 scaffold 的候选答案明显弱于直接作答提示。
4.4 更少的调用,同样的准确率开发集诊断
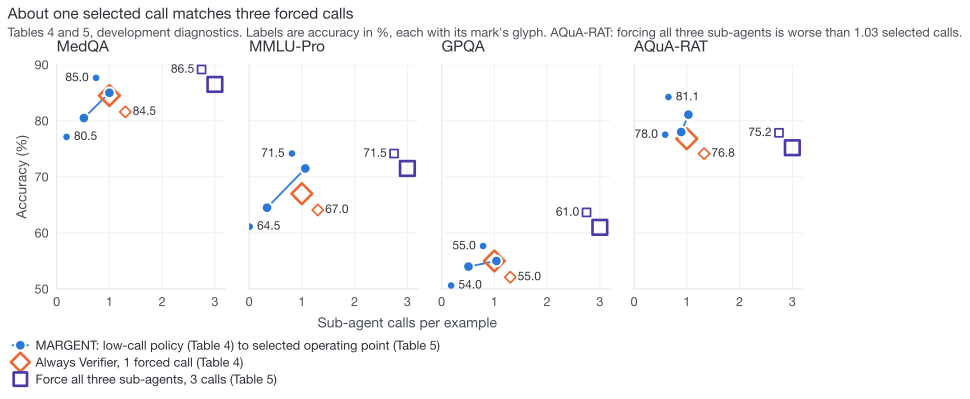
| 任务 | 选出的 MARGENT 准确率 | 调用 | 强制全部准确率 | 调用 | Δ 准确率 |
|---|---|---|---|---|---|
| MedQA | 85.0 | 1.000 | 86.5 | 3.0 | −1.5 |
| MMLU-Pro | 71.5 | 1.065 | 71.5 | 3.0 | 0.0 |
| GPQA | 55.0 | 1.040 | 61.0 | 3.0 | −6.0 |
| AQuA-RAT | 81.1 | 1.031 | 75.2 | 3.0 | +5.9 |
| 宏平均 | 73.2 | 1.034 | 73.6 | 3.0 | −0.4 |
在每题约一次选择性调用的操作点上,MARGENT 宏平均 73.2%@1.03 次,强制全部三个子智能体 73.6%@3.0 次:调用减到三分之一,准确率只低 0.4 分。MMLU-Pro 持平(71.5%),AQuA-RAT 反超(81.1% vs 75.2%),GPQA 仍落后 6.0 分。
另一组低调用操作点(论文表 4)比「每题强制调用一次 Verifier」少用 43.5% 的调用,准确率宏平均低约 1.6 分(论文正文数字);该基线没有把候选答案传给 Verifier,所以是强的操作基线,不是完全匹配的路由消融。
4.5 调用差与提交/救回比 ρ开发集诊断
调用差 = P(委派 | 候选答案错) − P(委派 | 候选答案对),在选出的开发集操作点上四个任务都为正:MedQA 0.381、MMLU-Pro 0.296、GPQA 0.067、AQuA-RAT 0.102。匹配预算重放(固定调用的角色和次数,题目随机重抽 2,000 次)中,MedQA 策略选中的子集达到 82.0%,高于随机区间 [75.0, 81.0];MMLU-Pro 和 GPQA 在区间内。
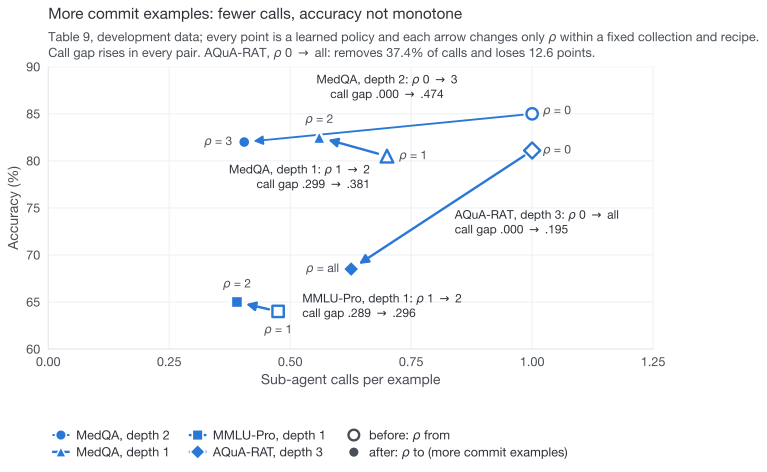
| 任务 / 采集集 | ρ | 准确率 | 调用 / 题 | 调用差 |
|---|---|---|---|---|
| MedQA 深度 2 | 0 → 3 | 85.0 → 82.0 | 1.000 → 0.405 | .000 → .474 |
| MedQA 深度 1 | 1 → 2 | 80.5 → 82.5 | .700 → .560 | .299 → .381 |
| MMLU-Pro 深度 1 | 1 → 2 | 64.0 → 65.0 | .475 → .390 | .289 → .296 |
| AQuA-RAT 深度 3 | 0 → all | 81.1 → 68.5 | 1.000 → .626 | .000 → .195 |
保留更多提交样本在每一对里都降低调用率,但准确率不单调:AQuA-RAT 的比较去掉了 37.4% 的调用,也丢了 12.6 分。
4.6 候选答案对委派的调用重要吗?开发集诊断
| 指标 | 传入候选答案 | 置空候选答案 |
|---|---|---|
| 准确率 (%) | 81.1 | 74.0 |
| 纠正(全部题目中的比例) | 0.480 | 0.409 |
| 损坏(全部题目中的比例) | 0.0240 | 0.0236 |
去掉候选答案后准确率从 81.1% 降到 74.0%,纠正从 0.480 降到 0.409,损坏基本不变;这次运行的路由是固定的,所以不能说明路由器用候选答案来决定要不要调用。
5. 附录诊断
| 运行 | 调用 / 题 | 准确率 | 观察到的行为 |
|---|---|---|---|
| MedQA,8B manager | 2.98 | – | 接近全部三次调用 |
| MedQA,9B manager | 3.00 | – | 全部三次调用;答案很晚才给出 |
只用结果奖励的 GRPO 继续训练退化到 2.98 和 3.00 次调用 / 题;两次运行的准确率在导出记录中缺失,所以只能说明调用行为,不能说明准确率损失。作为参照,一个固定的 MedQA MARGENT SFT 配置另外三个种子的结果是 80.5 ± 1.0 准确率、0.517 ± 0.043 次调用。